Una guía breve a la base del análisis de sistemas dinámicos. Publicado originalmente en The Deep Hub.
 Creada por el autor con DALL-E 3
Últimamente, los modelos de espacio de estados (State Space Models, SSM) se han vuelto populares en machine learning, especialmente tras el conocido paper de Mamba.
Las definiciones técnicas pueden parecer intimidantes: hablan de ecuaciones diferenciales, sistemas estocásticos y dinámicos. Son correctas, pero el concepto básico es más accesible.
Este artículo presenta los SSM desde cero y explica por qué son fundamentales en machine learning.
Modelos de espacio de estados
Dibujo de un coche | Fuente
Imagina un coche teledirigido cuyo movimiento queremos entender y predecir.
Los SSM describen su movimiento con dos ideas:
- Estado: una instantánea de todo lo que necesitamos saber: posición, dirección, velocidad, etc.
- Observación: lo que podemos ver o medir. Podemos conocer su posición sin conocer directamente su velocidad.
 Representación de fuerzas del coche | Fuente
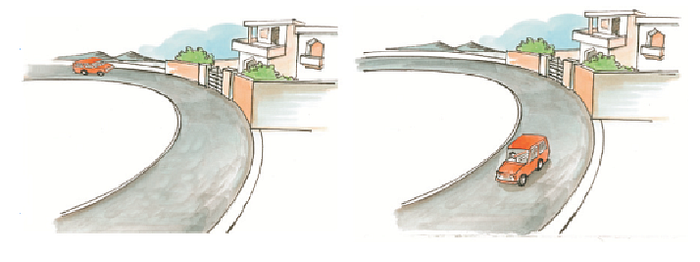 Observación de un coche | Fuente
En resumen, dividimos un sistema complejo en su estado interno y sus observaciones externas. Con ello podemos predecir su comportamiento futuro.
Sistemas dinámicos frente a estáticos
 Sistemas dinámicos | Fuente
Los sistemas dinámicos evolucionan y se adaptan con el tiempo cuando llega información nueva. Actualizan continuamente el modelo para refinar sus predicciones.
Los sistemas estáticos no cambian después de desplegarse: se apoyan en un modelo fijo entrenado con datos predefinidos.
 Sistemas estáticos frente a dinámicos | Fuente
Los sistemas dinámicos se ajustan a condiciones y patrones cambiantes; los estáticos funcionan mejor en entornos estables y previsibles.
SSM en machine learning: series temporales
Los SSM son especialmente útiles para series temporales, que cambian con el tiempo.
Clasificar imágenes de perros, gatos y pájaros es un problema esencialmente estático: las observaciones no dependen de una evolución temporal del sistema.
Predecir el tiempo meteorológico, en cambio, es dinámico. Los SSM se adaptan bien a los cambios de los datos con el tiempo.
 Análisis de series temporales | Fuente
Formulación matemática
Un SSM tiene una ecuación de estado y una ecuación de observación, ambas en función del tiempo t.
Tiempo discreto
Los modelos analizan el tiempo como una variable discreta, dividida en pasos: horas, días, semanas, etc. Cada paso es un punto separado en el tiempo. En un modelo diario, t = 1 sería el primer día y t = 2 el segundo.
 Variables continuas y discretas en SSM | Fuente
1. Ecuación de estado
Describe cómo evoluciona el estado entre pasos temporales:
- x(t): vector de estado en el instante t.
- A: matriz de transición de estado.
- B: matriz que mapea el efecto de las entradas u(t).
- w(t): ruido de estado, perturbaciones aleatorias o errores de modelado.
2. Ecuación de observación
Relaciona el estado interno con las salidas observables:
- y(t): vector de salida en t.
- C: matriz que mapea el estado a salidas observadas.
- D: relación directa entre entrada y salida.
- v(t): ruido de observación.
Las matrices principales son:
- A, transición de estado: explica cómo el estado actual determina el siguiente. En el coche, cómo posición y velocidad actuales influyen en las posteriores.
- B, entrada de control: recoge el efecto de controles externos: volante, acelerador y freno.
- C, salida: traduce el estado a lo que medimos, como los indicadores del salpicadero.
- D, transmisión directa: representa una relación entre entradas y salidas que no pasa por el estado; muchas veces es una matriz de ceros.
Estimar parámetros
Hay dos formas principales de determinar los parámetros:
Principios fundamentales
Podemos derivar matrices del sistema a partir de leyes físicas u otros principios específicos, algo habitual en ingeniería y física.
Principios físicos del sistema | Fuente
Ajuste a datos
También pueden estimarse con datos empíricos. Métodos comunes:
- Mínimos cuadrados y variantes.
- Expectation-Maximization (EM).
- Estimación de máxima verosimilitud (MLE).
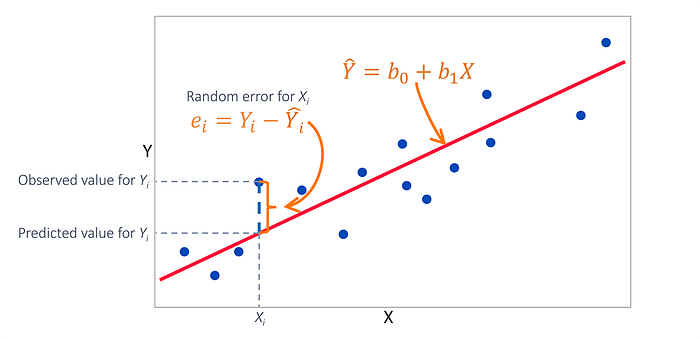 Concepto de mínimos cuadrados | Fuente
Hacer predicciones
Una vez creado el modelo, conocemos cómo se relacionan los pasos temporales. Podemos predecir el siguiente estado aplicando sus ecuaciones.
En condiciones reales hay incertidumbre. Para reducir sesgo y seguir la distribución de los datos se utilizan algoritmos de estimación, como:
- Filtros de partículas.
- Filtro de Kalman extendido.
- Estimación de horizonte móvil.
- Filtros bayesianos.
- Mínimos cuadrados.
El más popular es el filtro de Kalman.
Kalman Filter in a Nutshell Una introducción al filtro de Kalman con un ejemplo cotidiano.
Ejemplo: predicción meteorológica
Paso 1: definir variables
Observables: temperatura, humedad, presión barométrica y velocidad/dirección del viento. Podemos medirlas directamente.
Variables de estado: estabilidad atmosférica (S), contenido de humedad (M) y movimiento de masas de aire (A). No se miden directamente en un único punto.
Paso 2: definir pasos temporales
Podrían ser horarios o diarios. En este ejemplo actualizamos el modelo diariamente: todas las variables en t representan los datos recogidos cada día.
Paso 3: modelo matemático
Organizamos las variables observables y de estado en vectores y usamos:
X(t + 1) = F · X(t) + G · U(t) + w(t)
Y(t) = H · X(t) + v(t)
F define cómo el estado actual afecta al siguiente; G es la matriz de entradas; H conecta estado y observaciones; v(t) representa errores e incertidumbre de medición.
Paso 4: encontrar F y H
Podemos derivarlas teóricamente a partir de principios físicos o ajustarlas con datos mediante mínimos cuadrados, filtro de Kalman o máxima verosimilitud.
Cada f(i,j) expresa cómo la variable de estado j afecta a la variable i en el siguiente instante. Cada h(i,j) expresa cómo la variable de estado j afecta a la observable i.